九零登录

[【未通过】] 工具代码--简易轻量级爬虫

[复制链接]
发表于 2016-3-1 21:03:55 | 显示全部楼层 |阅读模式
[Python] 纯文本查看 复制代码
#-*-coding:utf-8-*-
#!/usr/bin/env python

import urllib2 
import cookielib

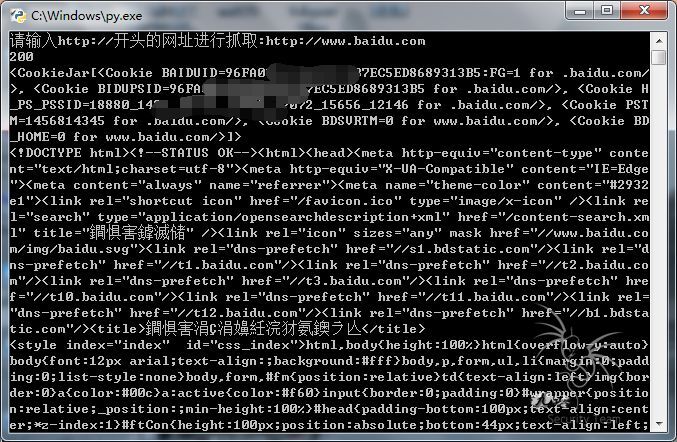
url=raw_input("请输入http://开头的网址进行抓取:")   #用raw_input将输入的网址传入url参数
a=urllib2.Request(url)
a.add_header('user-agent','Mozilla/5.0')                #伪装成浏览器
a.add_header('referer','http://www.baidu.com')     #伪装referer地址
cj=cookielib.CookieJar()                                       #设置cookie容器,有些需要cookie才能访问
opener=urllib2.build_opener(urllib2.HTTPCookieProcessor(cj))
urllib2.install_opener(opener)                                  
b=urllib2.urlopen(a)                                              #打开网址
print b.getcode()                                                  #打印出状态码,200则说明返回正常
print cj                                                                #打印出cookie
print b.read()                                                       #读取网站内容,并打印出来
xiumu=raw_input()                                               #防止运行完自动关闭
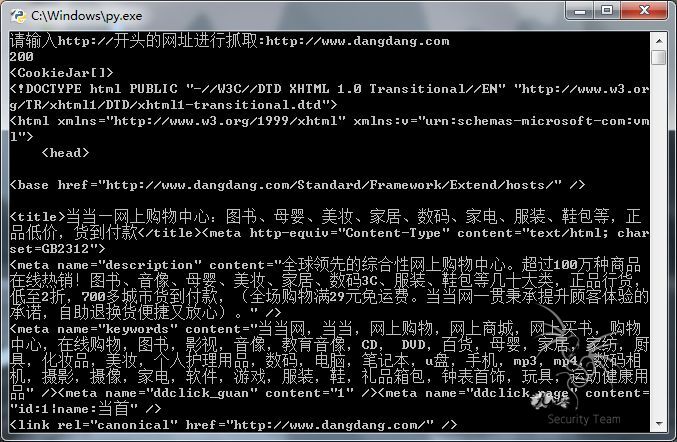

1.jpg
2.jpg

===================================================
工具过于简单,没有特色的思想和优化处理。
发表于 2016-3-1 22:34:37 | 显示全部楼层
这也能叫爬虫?着只是获取源码而已吧?爬呢,怎么不爬啊
发表于 2016-3-2 09:06:45 | 显示全部楼层
Bsmali4 发表于 2016-3-1 22:34
这也能叫爬虫?着只是获取源码而已吧?爬呢,怎么不爬啊

哈哈,表哥说话真实在,爬呢,你爬啊~~
发表于 2016-3-2 16:10:22 | 显示全部楼层
《如何用Python实现HTTP GET方法》
发表于 2016-3-2 16:18:09 | 显示全部楼层
支持2楼,最少也要有js动态加载的爬取吧
发表于 2016-3-2 16:33:28 | 显示全部楼层
这就不是爬虫吧
发表于 2016-3-2 16:40:39 | 显示全部楼层
没写完吧 需要抓取链接 清除非本站链接 然后进入循环抓取  再批量判断链接是否存在 再URL归类
发表于 2016-3-2 16:41:29 | 显示全部楼层
M4X 发表于 2016-3-2 16:10
《如何用Python实现HTTP GET方法》

应该是 <python标准库urrllib使用之GET请求>   好歹弄个正则啊
发表于 2016-3-2 22:57:52 | 显示全部楼层
requests模块就几行,楼主的代码有点过时了
路人  发表于 2016-3-3 15:57:53
感觉将爬虫和其他的漏洞模块合二为一比如sqlmapapi 或者其他的 就不错的

九零

GMT+8, 2026-10-22 13:25

Powered by Discuz! X3.5

© 2001-2026 Discuz! Team.

快速回复 返回顶部 返回列表