根据前辈:T0P丶乱 给出的接口地址
https://www.baidu.com/s?tn=baidulaonian&ie=utf-8&bs=site%253At00ls.net&cl=3&f=8&wd=site%3A90sec.org
给出的指点,重新修改了spider
不过在过程中,发现了一些不足
1.接口可能根据不同的浏览器(User-agent/内核)处理后返回的页面不相同
例如:
Uc(使用Chrome内核),访问后返回:
https://www.baidu.com/s?tn=98050039_dg&ie=utf-8&bs=site%253At00ls.net&cl=3&f=8&wd=site%3A90sec.org
火狐并没有重新跳转
2.搜索结果Page只能是去到11页
3.用语法和不使用语法搜索的结果并不相同
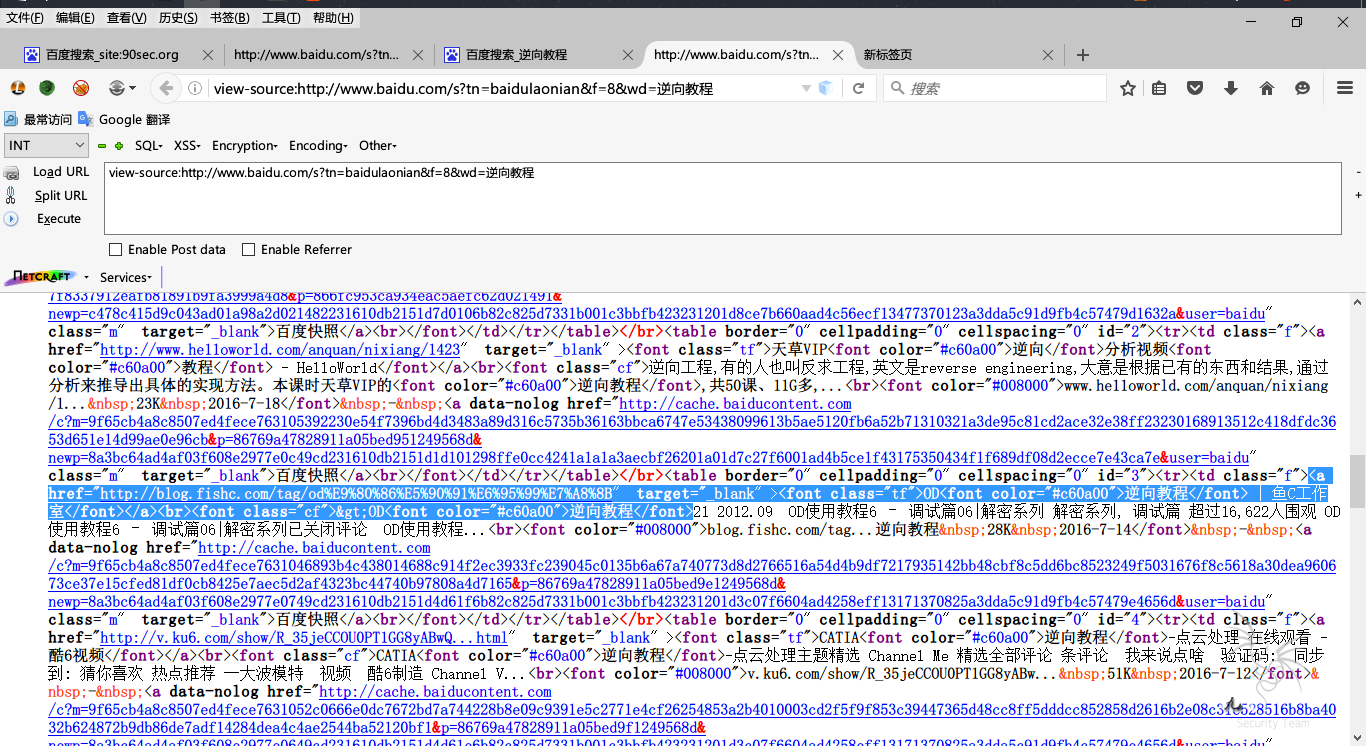
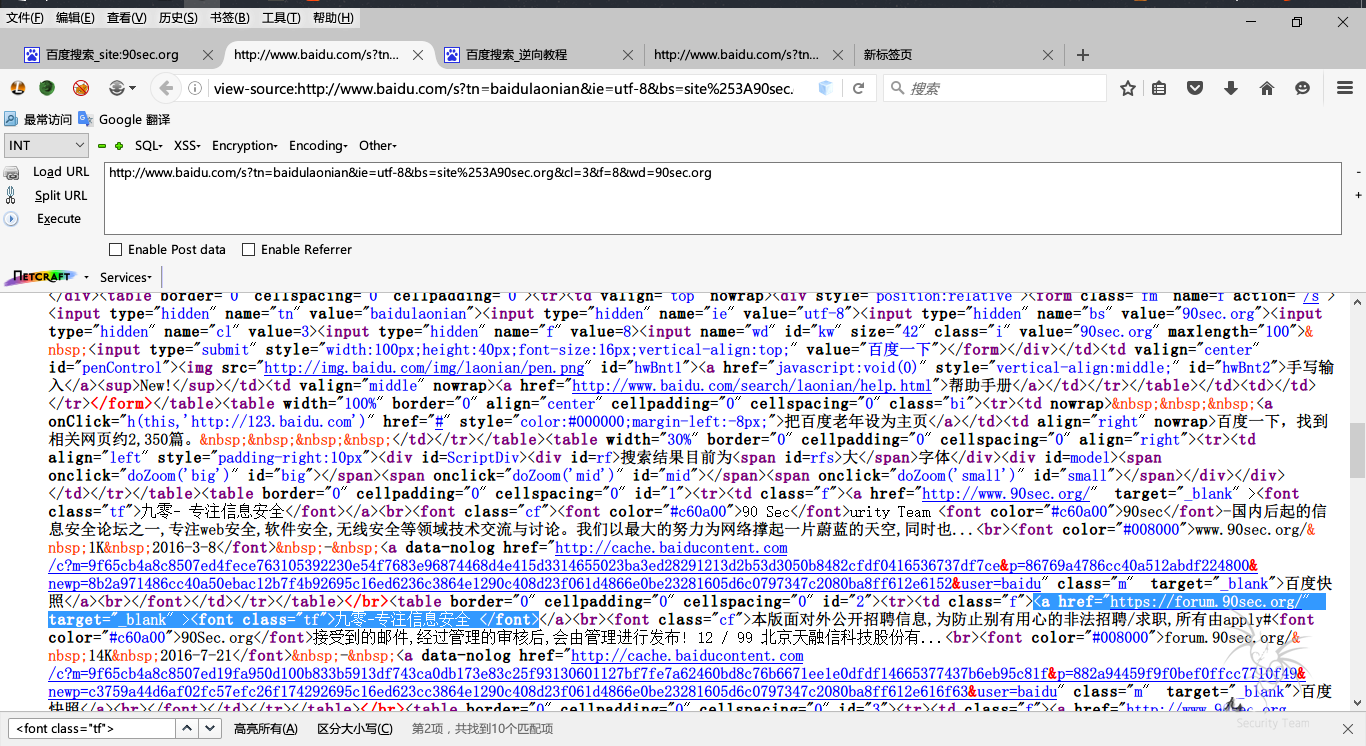
这就尴尬了
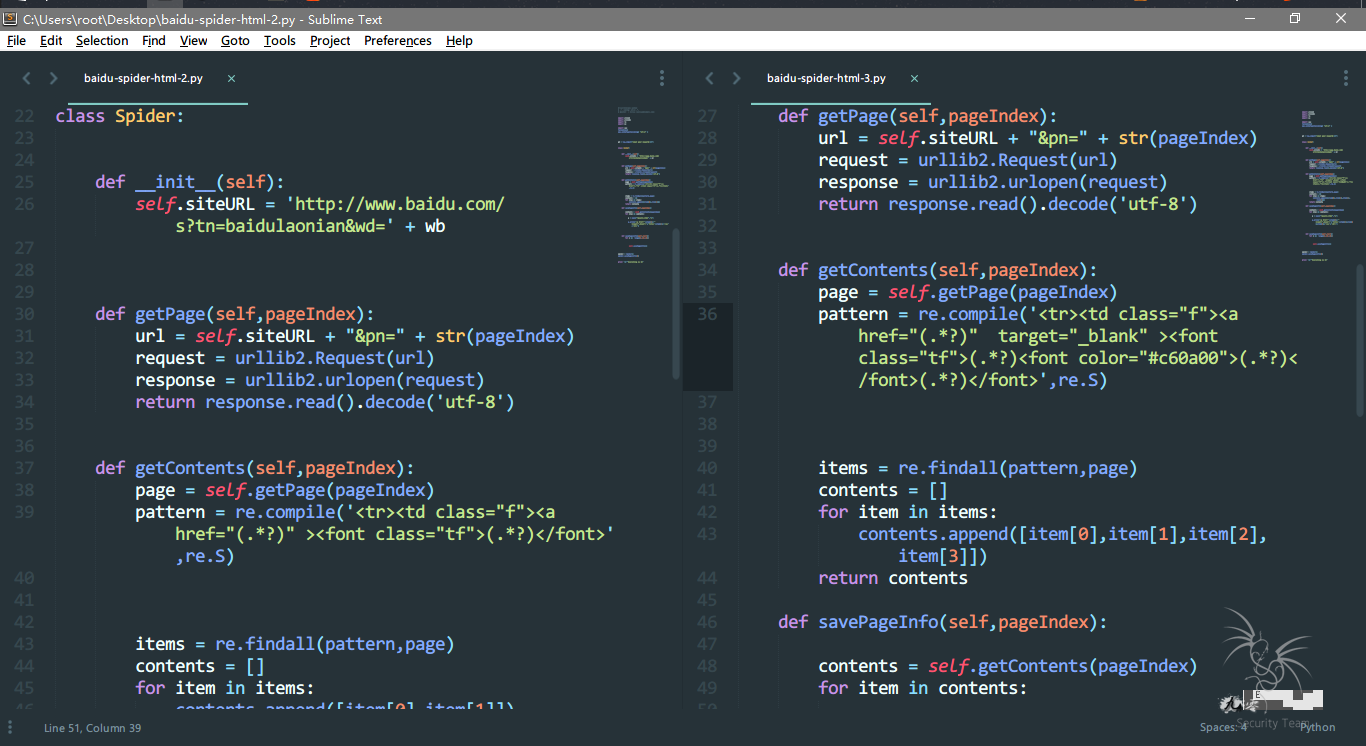
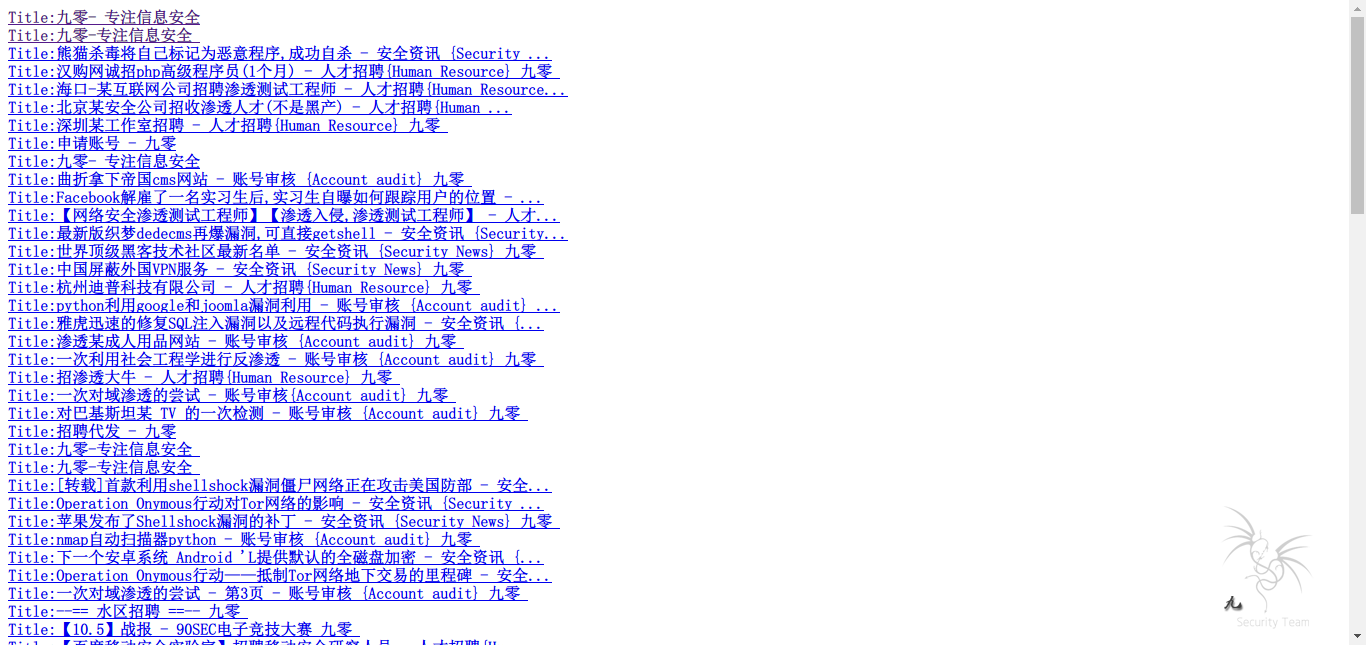
只能写两个爬虫,匹配不同的搜索结果
[Python] 纯文本查看 复制代码
#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Author  : Evilys ([email][email protected][/email])


import urllib
import urllib2
import re
import os

import sys
reload(sys)
sys.setdefaultencoding( "utf-8" )


wb = raw_input("input your keyword:\n")


class Spider:


    def __init__(self):
        self.siteURL = 'http://www.baidu.com/s?tn=baidulaonian&wd=' + wb


    def getPage(self,pageIndex):
        url = self.siteURL + "&pn=" + str(pageIndex)
        request = urllib2.Request(url)
        response = urllib2.urlopen(request)
        return response.read().decode('utf-8')


    def getContents(self,pageIndex):
        page = self.getPage(pageIndex)
        pattern = re.compile('<tr><td class="f"><a href="(.*?)" ><font class="tf">(.*?)</font>',re.S)


        items = re.findall(pattern,page)
        contents = []
        for item in items:
            contents.append([item[0],item[1]])
        return contents

    def savePageInfo(self,pageIndex):

        contents = self.getContents(pageIndex)
        for item in contents:

           y = open("results.html","a")

           y.write('<a href="'+item[0]+'" target="_blank">'+'Title:'+item[1]+'</a>'+'<br>')


    def savePagesInfo(self,start):
        for i in  range(0,110,10):


            self.savePageInfo(i)


spider = Spider()
spider.savePagesInfo(0)


print '\n'"Everything is OK"
[Python] 纯文本查看 复制代码
import urllib
import urllib2
import re
import os

import sys
reload(sys)
sys.setdefaultencoding( "utf-8" )


wb = raw_input("input your keyword:\n")


class Spider:


    def __init__(self):
        self.siteURL = 'http://www.baidu.com/s?tn=baidulaonian&wd=' + wb


    def getPage(self,pageIndex):
        url = self.siteURL + "&pn=" + str(pageIndex)
        request = urllib2.Request(url)
        response = urllib2.urlopen(request)
        return response.read().decode('utf-8')


    def getContents(self,pageIndex):
        page = self.getPage(pageIndex)
        pattern = re.compile('<tr><td class="f"><a href="(.*?)"  target="_blank" ><font class="tf">(.*?)<font color="#c60a00">(.*?)</font>(.*?)</font>',re.S)


        items = re.findall(pattern,page)
        contents = []
        for item in items:
            contents.append([item[0],item[1],item[2],item[3]])
        return contents

    def savePageInfo(self,pageIndex):

        contents = self.getContents(pageIndex)
        for item in contents:

           y = open("results.html","a")

           y.write('<a href="'+item[0]+'" target="_blank">'+'Title:'+item[1]+item[2]+item[3]+'</a>'+'<br>')


    def savePagesInfo(self,start):
        for i in  range(0,110,10):


            self.savePageInfo(i)


spider = Spider()
spider.savePagesInfo(0)


print '\n'"Everything is OK"
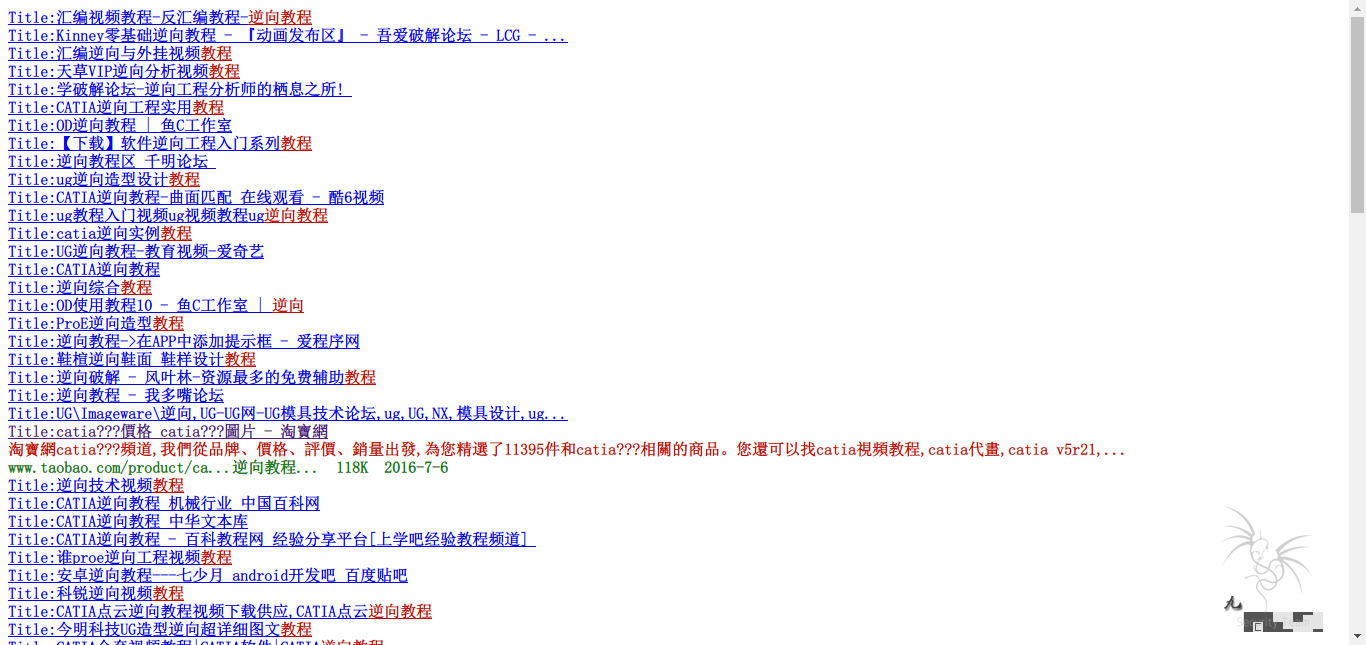
继续欢迎前辈们指出不足!
在这里,还是要感谢前辈T0P丶乱,万分感谢!
Life in debug!!
|