九零登录

[【通过】] 【已转正】python-baidu-spider

[复制链接]
发表于 2016-7-24 19:43:08 | 显示全部楼层 |阅读模式
本人菜鸡,学的python一些基础,写了一些爬虫,还望通过!
看到一篇投稿爬虫的文章:


http://forum.90sec.org/forum.php?mod=viewthread&tid=9221


我就再试试投一篇,望通过


贴上代码:
[Python] 纯文本查看 复制代码
#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Date    : 2015-1-24 20:34:30
# @Author  : Evilys ([url=mailto:[email protected]][email protected][/url])


import urllib

import urllib2

import re


print '''
                   Baidu Spiders V1.0.2
     1.  The value must be in multiples of 10!  
'''


wb = raw_input("input your keywords:\n")  #这里输入你的关键词/Input your keywords here

Pagenumber = raw_input("input your value:\n")  #必须是10的倍数


class BadiuSpider:


    def __init__(self):


        self.URL = 'http://www.baidu.com/s?wd=' + wb + '&pn=' + Pagenumber 


    def getPage(self,code):

        url = self.URL 

        request = urllib2.Request(url)

        response = urllib2.urlopen(request)

        return response.read().decode('utf-8')


    def getContents(self,code):

        page = self.getPage(code)

        pattern = re.compile('none;">(.*?) </a>',re.S)

        result = re.findall(pattern,page)

        for results in result:

         y = open("results.txt","a") 

         y.writelines(results+'\n')

         y.close()


Badiuspider = BadiuSpider()

Badiuspider.getContents(1)


print "Everything is OK"


QQ截图20160724153429.png

Github:https://github.com/Evilys/Spider


都是一开始写的版本了!(写的并不好,很多都没有经过处理)

然后基友说,要我写个爬虫,来爬写关于逆向的教程,

就有了一下的修改优化版本,

QQ图片20160724173602.jpg


value是每页的参数,百度的下一页是10跳的,

基友说这样,不方便,要打印出来,加上百度的全部结果。


然后,继续查看百度的页面参数,是去到750然后就显示限于篇幅,部分结果未予显示。


QQ图片20160724173615.jpg


QQ图片20160724175625.jpg

注意百度的Url是要经过跳转才能访问到真实的域名

这里我就没经过301重定向候的处理
技术太水,还不会写,求大神支教!

好吧那只好写个for循环,将内容跑跑下来,


QQ图片20160724173625.png
最后贴上代码

输出结果保存为HTML文件

[Python] 纯文本查看 复制代码
#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Author  : Evilys ([url=mailto:[email protected]][email protected][/url])

 
import urllib
import urllib2
import re
import os

import sys
reload(sys)
sys.setdefaultencoding( "utf-8" )


wb = raw_input("input your keyword:\n")  


class Spider:
 

    def __init__(self):
        self.siteURL = 'http://www.baidu.com/s?wd=' + wb


    def getPage(self,pageIndex):
        url = self.siteURL + "&pn=" + str(pageIndex)
        request = urllib2.Request(url)
        response = urllib2.urlopen(request)
        return response.read().decode('utf-8')
 

    def getContents(self,pageIndex):
        page = self.getPage(pageIndex)
        pattern = re.compile('<div class="f13"><a target="_blank" href="(.*?)" class="c-showurl" style="text-.*?{"title":"(.*?)","url"',re.S)

        #none;">(.*?) .*?{"title":"(.*?)","url
        #<div class="f13"><a target="_blank" href="(.*?)" class="c-showurl" style="text-.*?{"title":"(.*?)","url"

        items = re.findall(pattern,page)
        contents = []
        for item in items:
            contents.append([item[0],item[1]])
        return contents
 
    def savePageInfo(self,pageIndex):

        contents = self.getContents(pageIndex)
        for item in contents:
            
           y = open("results.html","a") 

           y.write('<a href="'+item[0]+'" target="_blank">'+'Title:'+item[1]+'</a>'+'<br>')


    def savePagesInfo(self,start):
        for i in  range(0,760,10):


            self.savePageInfo(i)


spider = Spider()
spider.savePagesInfo(0)


print '\n'"Everything is OK"

==============================
态度端正,积极寻求解决问题方案,管理给予通过。
                                      管理05


单选投票, 共有 16 人参与投票
31.25% (5)
68.75% (11)
您所在的用户组没有投票权限

评分

参与人数 1酒票 +5 收起 理由
管理05 + 5 欢迎加入90!

查看全部评分

发表于 2016-7-24 21:03:26 | 显示全部楼层
https://www.baidu.com/s?tn=baidu ... wd=site%3A90sec.org
用这个接口你就能写好了。
 楼主| 发表于 2016-7-24 21:20:32 | 显示全部楼层
T0P丶乱 发表于 2016-7-24 21:03
https://www.baidu.com/s?tn=baidulaonian&ie=utf-8&bs=site%253At00ls.net&cl=3&f=8&wd=site%3A90sec.org
...

http://www.baidu.com/s?wd=

和这个接口并没什么不同吧
 楼主| 发表于 2016-7-24 21:24:18 | 显示全部楼层
T0P丶乱 发表于 2016-7-24 21:03
https://www.baidu.com/s?tn=baidulaonian&ie=utf-8&bs=site%253At00ls.net&cl=3&f=8&wd=site%3A90sec.org
...

我说的是,不会处理301跳转之后的!!!前辈!

求指点!
发表于 2016-7-24 21:31:03 | 显示全部楼层
chr7s 发表于 2016-7-24 21:24
我说的是,不会处理301跳转之后的!!!前辈!

求指点!

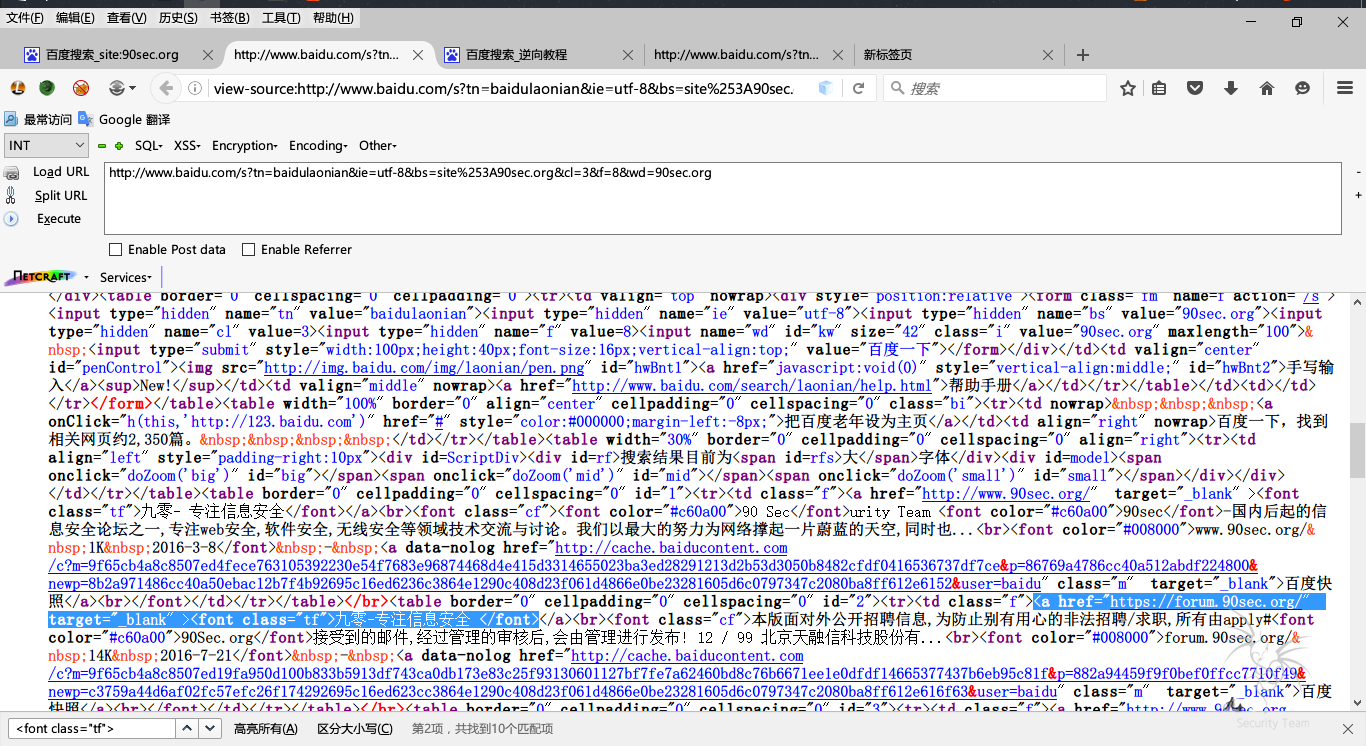
view-source:https://www.baidu.com/s?tn=baidu ... wd=site%3A90sec.org

<a href="http://forum.90sec.org/thread-8413-1-1.html"  target="_blank" ><font class="tf">熊猫杀毒将自己标记为恶意程序,成功自杀 - 安全资讯 {Security ...</font></a>

直接抓到原始地址

发表于 2016-7-24 23:07:36 | 显示全部楼层
楼主的问题不太难,找些详细资料应该可以解决,但只见到楼主解决了一半,希望多加努力。
 楼主| 发表于 2016-7-24 23:20:25 | 显示全部楼层
根据前辈:T0P丶乱 给出的接口地址
https://www.baidu.com/s?tn=baidulaonian&ie=utf-8&bs=site%253At00ls.net&cl=3&f=8&wd=site%3A90sec.org


给出的指点,重新修改了spider

不过在过程中,发现了一些不足

1.接口可能根据不同的浏览器(User-agent/内核)处理后返回的页面不相同

例如:

Uc(使用Chrome内核),访问后返回:
https://www.baidu.com/s?tn=98050039_dg&ie=utf-8&bs=site%253At00ls.net&cl=3&f=8&wd=site%3A90sec.org

火狐并没有重新跳转


2.搜索结果Page只能是去到11页
3.用语法和不使用语法搜索的结果并不相同
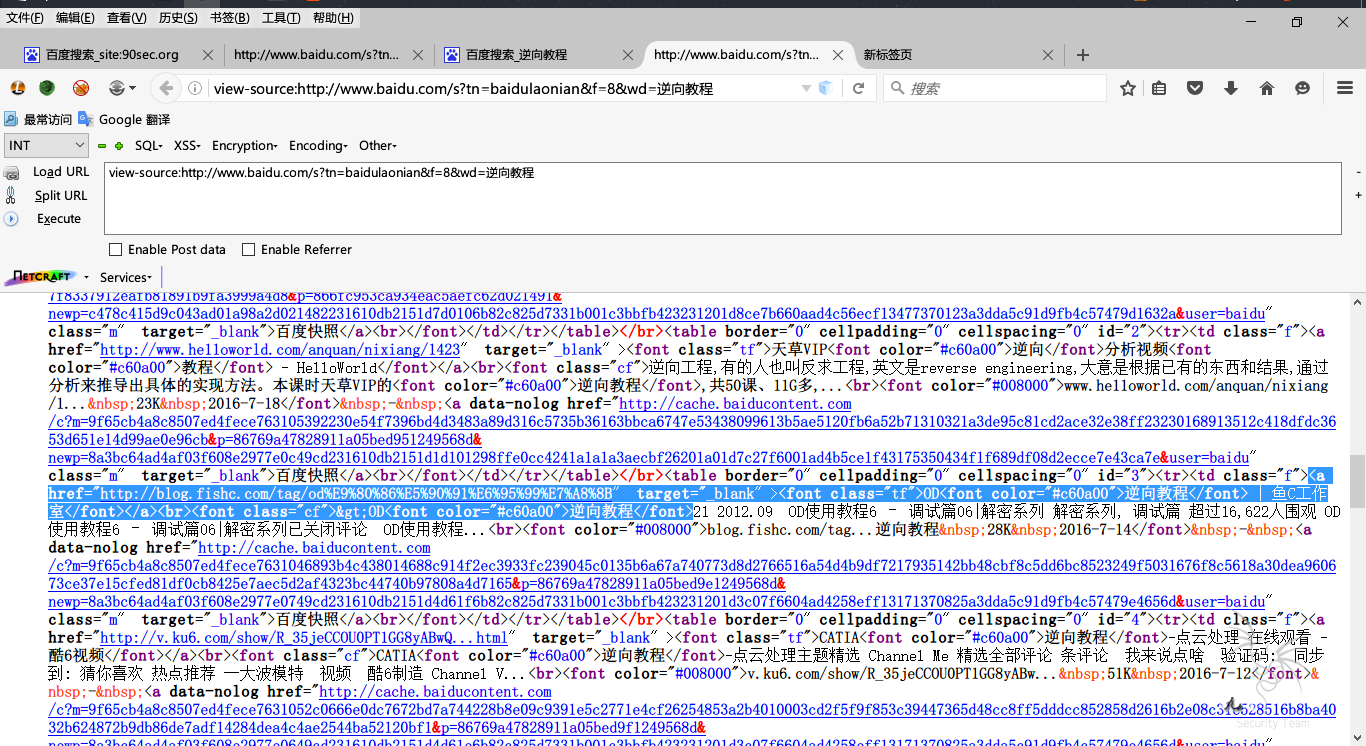

2.png

1.png


这就尴尬了

只能写两个爬虫,匹配不同的搜索结果

3.png


[Python] 纯文本查看 复制代码
#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Author  : Evilys ([email][email protected][/email])

 
import urllib
import urllib2
import re
import os

import sys
reload(sys)
sys.setdefaultencoding( "utf-8" )


wb = raw_input("input your keyword:\n")  


class Spider:
 

    def __init__(self):
        self.siteURL = 'http://www.baidu.com/s?tn=baidulaonian&wd=' + wb


    def getPage(self,pageIndex):
        url = self.siteURL + "&pn=" + str(pageIndex)
        request = urllib2.Request(url)
        response = urllib2.urlopen(request)
        return response.read().decode('utf-8')
 

    def getContents(self,pageIndex):
        page = self.getPage(pageIndex)
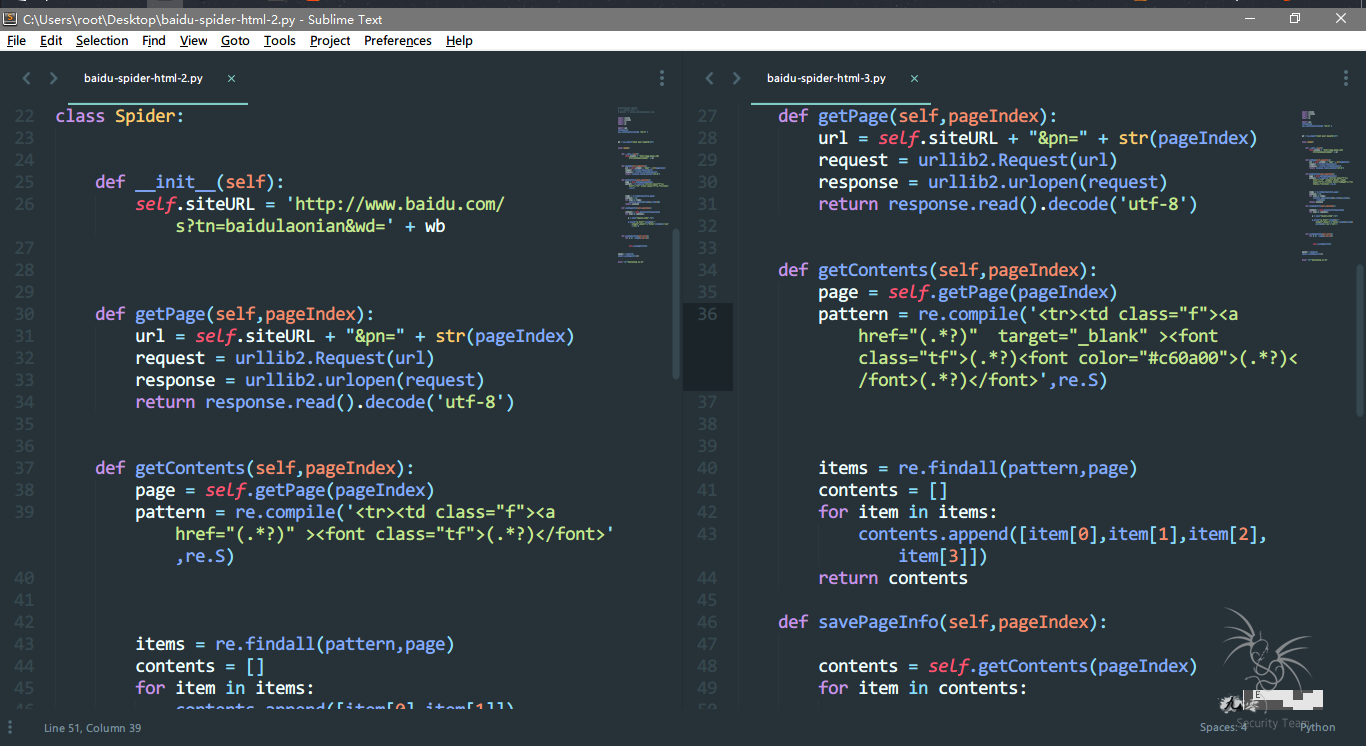
        pattern = re.compile('<tr><td class="f"><a href="(.*?)" ><font class="tf">(.*?)</font>',re.S)


        items = re.findall(pattern,page)
        contents = []
        for item in items:
            contents.append([item[0],item[1]])
        return contents
 
    def savePageInfo(self,pageIndex):

        contents = self.getContents(pageIndex)
        for item in contents:
            
           y = open("results.html","a") 

           y.write('<a href="'+item[0]+'" target="_blank">'+'Title:'+item[1]+'</a>'+'<br>')


    def savePagesInfo(self,start):
        for i in  range(0,110,10):


            self.savePageInfo(i)


spider = Spider()
spider.savePagesInfo(0)


print '\n'"Everything is OK"
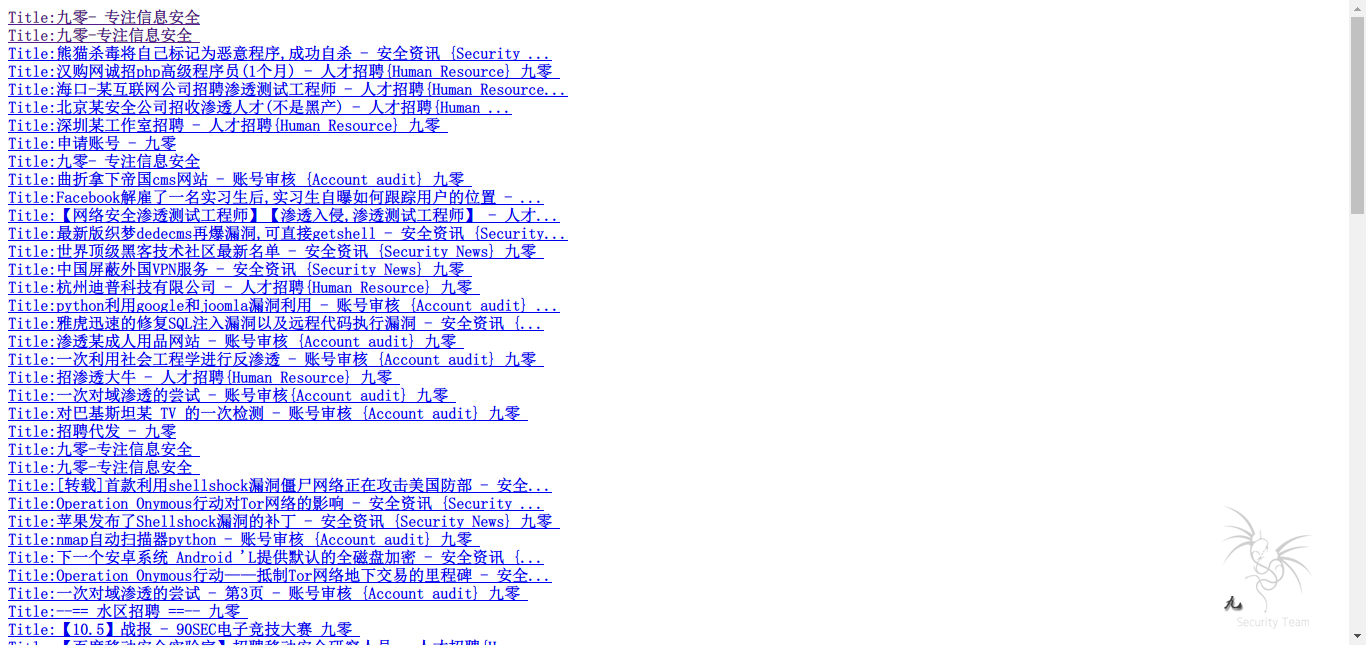

4.png


[Python] 纯文本查看 复制代码

 
import urllib
import urllib2
import re
import os

import sys
reload(sys)
sys.setdefaultencoding( "utf-8" )


wb = raw_input("input your keyword:\n")  


class Spider:
 

    def __init__(self):
        self.siteURL = 'http://www.baidu.com/s?tn=baidulaonian&wd=' + wb


    def getPage(self,pageIndex):
        url = self.siteURL + "&pn=" + str(pageIndex)
        request = urllib2.Request(url)
        response = urllib2.urlopen(request)
        return response.read().decode('utf-8')
 

    def getContents(self,pageIndex):
        page = self.getPage(pageIndex)
        pattern = re.compile('<tr><td class="f"><a href="(.*?)"  target="_blank" ><font class="tf">(.*?)<font color="#c60a00">(.*?)</font>(.*?)</font>',re.S)


        items = re.findall(pattern,page)
        contents = []
        for item in items:
            contents.append([item[0],item[1],item[2],item[3]])
        return contents
 
    def savePageInfo(self,pageIndex):

        contents = self.getContents(pageIndex)
        for item in contents:
            
           y = open("results.html","a") 

           y.write('<a href="'+item[0]+'" target="_blank">'+'Title:'+item[1]+item[2]+item[3]+'</a>'+'<br>')


    def savePagesInfo(self,start):
        for i in  range(0,110,10):


            self.savePageInfo(i)


spider = Spider()
spider.savePagesInfo(0)


print '\n'"Everything is OK"
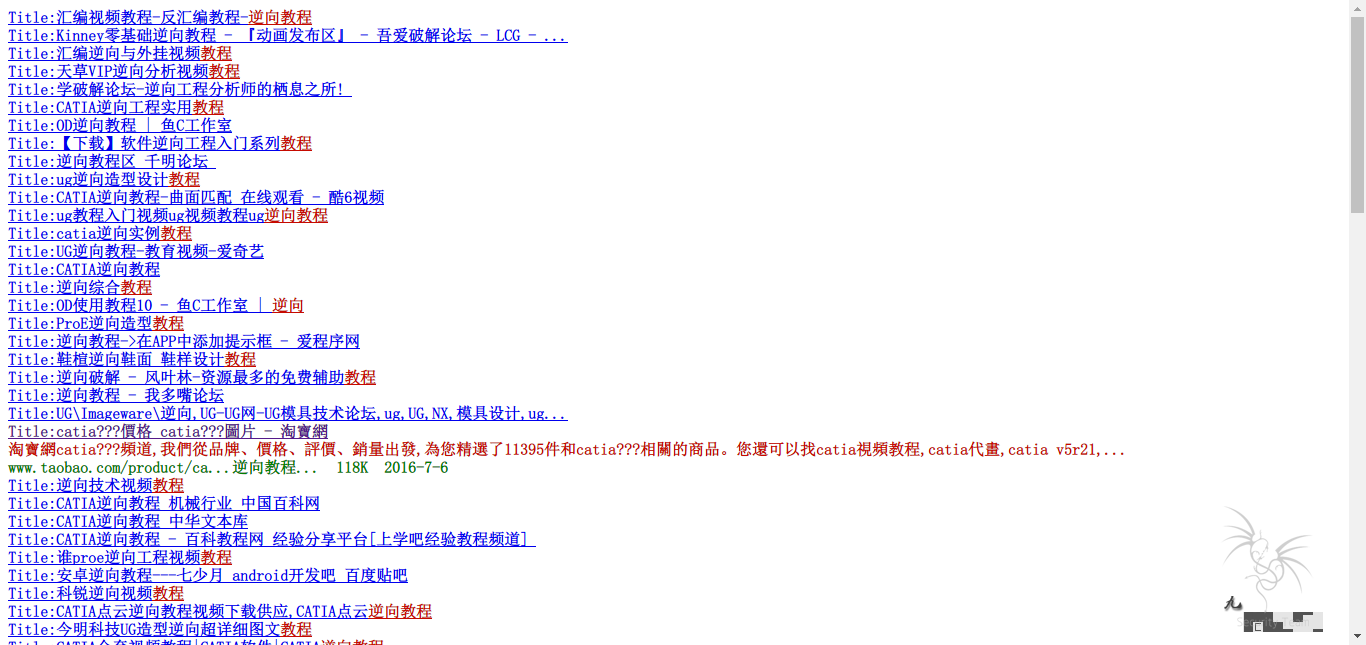

5.png


继续欢迎前辈们指出不足!


在这里,还是要感谢前辈T0P丶乱,万分感谢!


Life in debug!!


发表于 2016-7-25 08:16:21 | 显示全部楼层
主要这个东西意义不算太大。。。
发表于 2016-7-25 10:01:13 | 显示全部楼层
chr7s 发表于 2016-7-24 23:20
根据前辈:T0P丶乱 给出的接口地址

翻页多了百度没让你输验证码么?好奇怪。
另求问下你 sublime 的字体和主题是什么,挺漂亮的。
发表于 2016-7-25 10:47:59 | 显示全部楼层
我也写过一些爬虫,从楼主这里还是找到一些亮点,很值得自己琢磨,不过评论中的信息量更大

正在学习...
 楼主| 发表于 2016-7-25 12:28:32 | 显示全部楼层
40huo 发表于 2016-7-25 10:01
翻页多了百度没让你输验证码么?好奇怪。
另求问下你 sublime 的字体和主题是什么,挺漂亮的。

并没有出现验证码啊
发表于 2016-11-9 13:24:41 | 显示全部楼层
[Python] 纯文本查看 复制代码
     
     def getSourceLinks(self,url):
        request = urllib2.Request(url)
        request.get_method = lambda : 'HEAD'
        response = urllib2.urlopen(request)
        return response.geturl()

     def getContents(self,pageIndex):
        page = self.getPage(pageIndex)
        pattern = re.compile('<div class="f13"><a target="_blank" href="(.*?)" class="c-showurl" style="text-.*?{"title":"(.*?)","url"',re.S)
        items = re.findall(pattern,page)
        contents = []
        for item in items:
            decodeurl = self.getSourceLinks(item[0])
            contents.append([decodeurl,item[1]])
        return contents


帮你加上恢复原始链接了

评分

参与人数 1酒票 +2 收起 理由
管理05 + 2 积极参与讨论

查看全部评分

九零

GMT+8, 2026-10-22 13:24

Powered by Discuz! X3.5

© 2001-2026 Discuz! Team.

快速回复 返回顶部 返回列表